《数据的复杂采集、脱敏、归一与向量化》
从校园公开 HTML、PDF 与课件,到可检索、可引用、可追溯的统一知识表示:记录 TJUClaw 数据管道背后的采集、脱敏、归一与向量化设计。
《数据的复杂采集、脱敏、归一与向量化》
做一个校园知识库,最容易产生的错觉,是认为问题可以被简化成:
PDF → 切片 → Embedding → 向量数据库真正做下去以后,会发现 Embedding 几乎已经是整条链路里最靠后的部分。
在它之前,还有 HTML、动态列表、课程网盘、扫描 PDF、旧版 PPT、没有扩展名的下载流;有重复文件,有随时可能修改的通知,也有混杂在公开材料里的邮箱、手机号、学号甚至配置密码。
如果直接把这些东西扔进知识库,得到的并不是「校园知识」,而是一堆来源不稳定、格式不统一、无法复核,也很难安全使用的文本碎片。
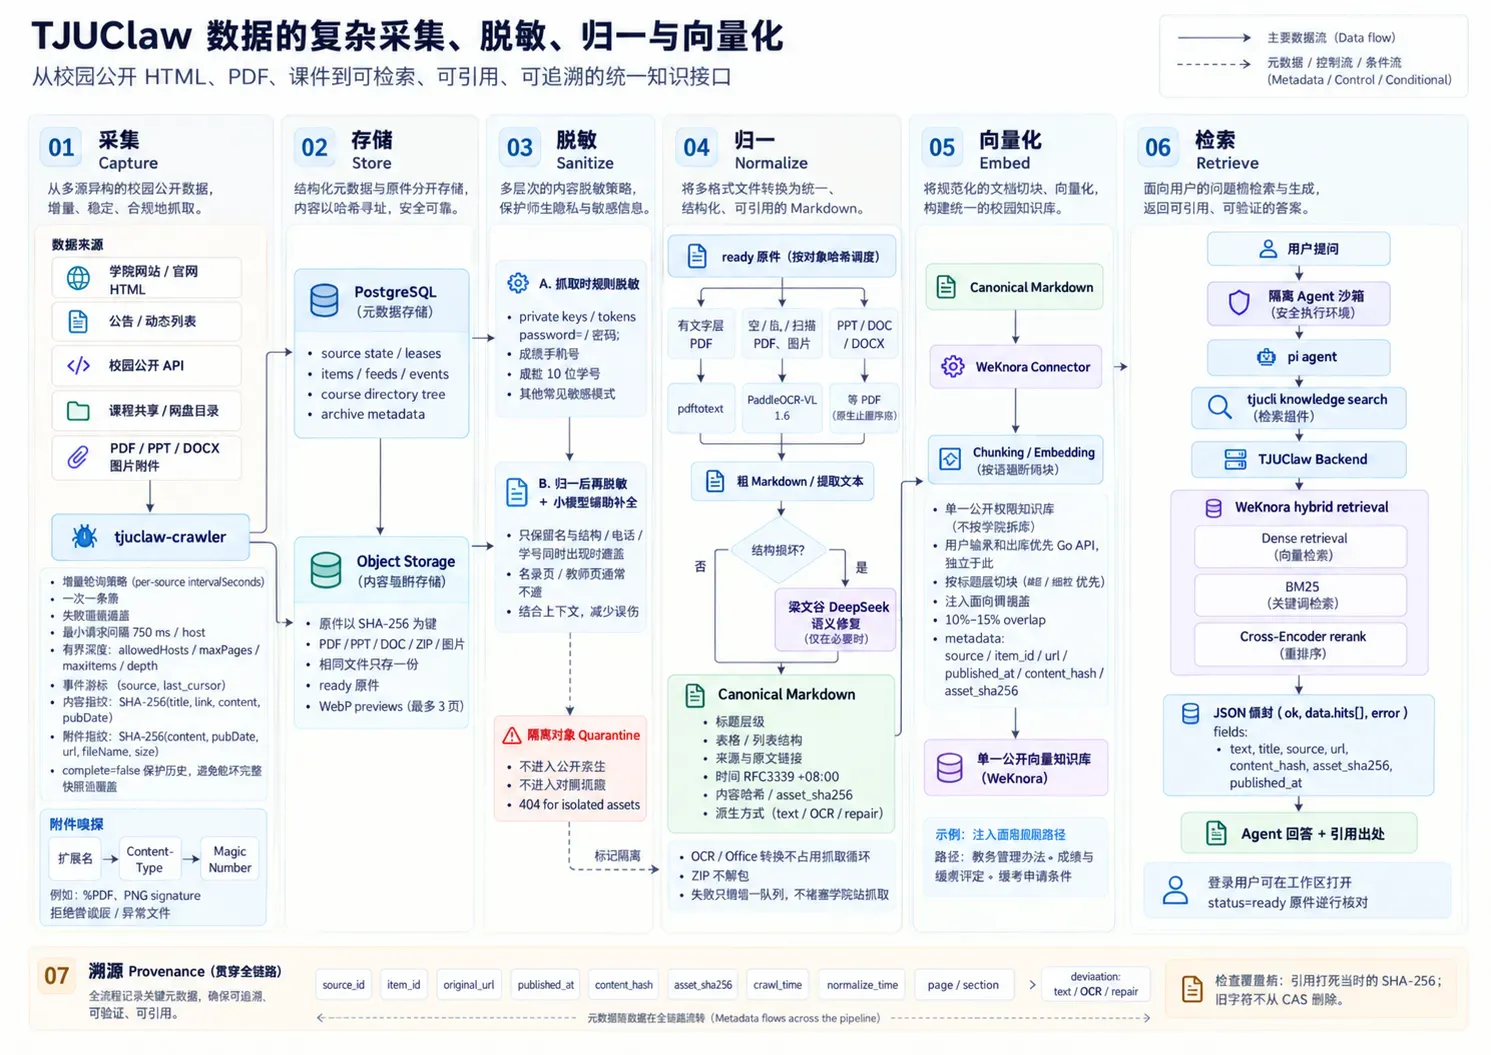
所以 TJUClaw 最终需要的不是一个「能够搜索 PDF 的网站」,而是一条更完整的数据管道:
公开校园数据
    ↓
采集与有界发现
    ↓
PostgreSQL / 内容寻址对象存储
    ↓
规则脱敏
    ↓
文档归一化
    ↓
二次脱敏与必要的语义修复
    ↓
Canonical Markdown
    ↓
Chunking / Embedding / Hybrid Retrieval
    ↓
WeKnora
    ↓
tjucli knowledge search
    ↓
Agent
Agent 最终看到的,也许只有这样一条命令:
tjucli knowledge search "软件工程培养方案"但这一行命令真正依赖的,是前面那条并不那么显眼的数据基础设施。
向量化以前,先解决数据到底是什么
校园公开数据有一个很明显的特点:它并不是作为“数据集”存在的。
同一个学校里,可以同时存在:
- 学院官网上的 HTML 新闻;
- 教务系统返回的结构化接口;
- 课程网站里的 PDF;
- 教师上传的 Word、PPT;
- 扫描版规章制度;
- 网盘式课程目录;
- 没有扩展名的下载链接。
这些来源的更新周期、结构稳定性和访问方式完全不同。
因此在 TJUClaw 里,我们没有试图寻找一个能够统一处理所有来源的「万能爬虫」。
更现实的做法,是先把问题拆开:
采集阶段只负责发现和保存事实,归一阶段再负责理解文件。
这条边界后来变得非常重要。
如果 OCR、Office 转换、模型修复全部塞进抓取流程,那么一个几十页的扫描 PDF 就足以阻塞后面整个学院站的更新。反过来,如果抓取器只负责把原始对象可靠保存下来,那么 OCR 服务宕机、模型限流,甚至整个解析方案以后被替换,都不会要求重新访问源站。
原件是事实。
Markdown、OCR 结果和向量都是派生物。
先保存事实,再决定怎样解释它。
采集不是越快越好
最开始写爬虫时,很自然会想:
for source in sources:
    crawl(source)
再进一步,很容易变成:
Promise.all(sources.map(crawl))对于几十个共享同一出口的校园网站,这通常不是一个好主意。
很多学院站本身并没有为大规模并发访问设计。它们甚至可能运行在年代久远的 CMS 上。对我们而言,数据晚几分钟进入知识库几乎没有区别;但一次性并发扫几十个站点,对对方服务器和自己的出口都会产生没有必要的压力。
因此 TJUClaw 的 crawler 更像一个非常克制的轮询器。
每个数据源都有自己的更新周期:
source A ── 每小时
source B ── 每天
source C ── 每天
...
调度器寻找已经到期的源,一次处理一个。失败后退避,而不是立刻重试。
同一主机之间还保留最小请求间隔。
这使得爬虫在绝大多数时间里显得相当「无聊」:CPU 占用很低,连接数也不多。
但这恰恰是我们想要的状态。
采集公开数据没有必要变成压力测试。
最危险的不是漏抓,而是把“没抓到”理解成“已经不存在”
在动态网站里,一个非常容易被忽略的问题是:
一次抓取结果,是否代表远端完整状态?
很多时候答案是否定的。
分页接口可能超时,学院网站可能临时返回 500,课程目录枚举可能因为部署重启只跑到一半。
如果把每一次抓取都当作远端世界的完整快照,就会出现一个非常糟糕的结果:
这次只抓到 20 条
↓
数据库原来有 3000 条
↓
剩下 2980 条被判断为“已删除”
因此,大部分 TJUClaw 数据源默认都是:
complete = false含义不是「任务失败」,而是:
我只能证明这些东西存在,不能证明没出现的东西已经不存在。
只有能够确认完整枚举的数据源,才有资格删除不存在于新快照中的历史记录。
对于增量消费,我们另外维护单调递增的事件游标。
这里的 cursor 并不是对方网站分页接口提供的 token,而是自己数据库中的事件编号:
upsert article → event 12031
upsert article → event 12032
delete article → event 12033
这样 RSS、索引器以及其他消费者读取的是自己的事件流,而不是把第三方网站的分页行为当成可靠状态机。
这是一处很小的设计,却让采集系统从「定时脚本」变成了可以重放的数据源。
内容寻址:先把原件保存下来
对于帖子正文,PostgreSQL 很合适。
对于几十兆的 PPT、PDF、ZIP,则完全没有必要把二进制塞进数据库。
因此 TJUClaw 的数据在进入系统时就被分成两类:
PostgreSQL
├── source
├── item
├── event
├── directory
└── asset metadata

Object Storage
├── PDF
├── PPT / DOC
├── ZIP
├── image
└── derived preview
对象存储里的文件不按照原文件名寻址,而是按照内容哈希:
SHA-256(file bytes)这样,同一份培养方案即使同时被三个学院网站转载,也只需要保存一次。
这也带来了另一个后来非常重要的能力:版本不会因为源站修改而消失。
假设一份通知今天被修改。
新的版本会产生新的哈希:
old:
sha256:aaaa...

new:
sha256:bbbb...
搜索系统可以更新到新版,但以前生成的笔记仍然可以继续引用:
sha256:aaaa...这意味着「引用」不再只是一个 URL。
它指向的是某一个确定的字节序列。
不要相信 .pdf
课程资源里有一种很常见的 URL:
/download?file_id=1028也可能出现另一种情况:
lecture.pdf但服务器实际返回的是 HTML 错误页面。
因此文件类型不能只依赖扩展名。
我们会同时检查:
文件扩展名
    ↓
HTTP Content-Type
    ↓
Magic Number
例如 PDF 文件头:
const isPdf =
  bytes[0] === 0x25 &&
  bytes[1] === 0x50 &&
  bytes[2] === 0x44 &&
  bytes[3] === 0x46;
也就是:
%PDFPNG 也有固定的文件签名:
const isPng =
  bytes[0] === 0x89 &&
  bytes[1] === 0x50 &&
  bytes[2] === 0x4e &&
  bytes[3] === 0x47 &&
  bytes[4] === 0x0d &&
  bytes[5] === 0x0a &&
  bytes[6] === 0x1a &&
  bytes[7] === 0x0a;
这并是什么复杂技术,但对于一个长期运行的数据入口来说,这种无聊的检查往往比后面的模型能力重要得多。
因为进入对象存储的原件最终会成为整个知识系统的事实基础。
入口越宽松,后面需要处理的垃圾就越多。
脱敏并不是“一条正则”
校园公开资料还有另一个麻烦:
公开可访问,不意味着所有内容都适合进入一个可以自然语言检索的知识库。
网页上的信息原本可能埋在一份几十页 PDF 的附表里。
一旦被切片、向量化,再允许模型直接搜索:
帮我找一下 XXX 的联系方式信息的可访问性就发生了变化。
因此,TJUClaw 把脱敏分成两层。
第一层发生在采集阶段,使用确定性的规则。
它主要处理一些没有多少语义歧义的内容:
Private Key
代码托管令牌
AWS 风格密钥
password=...
密码: ...
以及明显呈现名单结构的大批学号、手机号。
规则的优点很简单:
快,而且可以解释。
同一段文本,无论什么时候进入系统,都会得到相同结果。
但规则也有明显极限。
例如:
张三
zhangsan@example.edu.cn
人类一眼就知道这两行属于同一个人,而普通正则并不能稳定建立这种关系。
所以文档归一以后还会进行第二次脱敏。
这一层使用 DeepSeek V4.1 Flash,但它受到非常窄的任务约束:
只判断姓名是否与邮箱、电话、学号等个人标识共同出现。
我们并不希望模型看到「张三教授」就自动把名字删掉。
教授主页、学院领导页面、论文作者等公开身份信息本来就是校园知识的一部分。
真正需要避免的是:
姓名 + 私人联系方式
姓名 + 学号
名单式个人信息
这种组合被搜索系统重新放大。
脱敏本质上不是寻找一个完美正则,而是在信息可用性和重新聚合风险之间划一道边界。
而且这种边界永远不应该被描述成「零误报」。
例如 password: 很可能只是课程讲义中的示例。
但对于公开知识库,我们宁愿隔离一份讲义,也不希望偶然放进去一组真实凭证。
Markdown 是我们的中间表示
处理文档时,还有一个问题:
到底应该把什么东西交给后面的知识库?
纯文本很简单,但结构损失严重。
HTML 保留结构,却混入大量页面样式和导航。
JSON 对程序友好,但对于长文档来说既冗长又没有必要。
最终我们选择 Markdown 作为 Canonical Representation。
原因并不神秘。
它同时具备:
# 标题
## 小节

- 列表

| 表格 |
| --- |

> 引用
也就是足够表达绝大多数校园文档结构,但语法本身又非常轻。
不过,并不是所有原件都通过同一条路径转换。
归一过程大致如下:
ready 原件
    │
    ├── 文本型 PDF ─────────────→ pdftotext
    │
    ├── 扫描 PDF / 图片 ────────→ PaddleOCR-VL 1.6
    │
    └── PPT / DOC / DOCX
                │
                ↓
              PDF
                │
                └──────────────→ 同上
转换完成以后再进行第二轮脱敏。
只有两类对象才会进入生成式处理:结构明显损坏的 Markdown,以及规则认为需要语境补全的文本。其余干净公文直接成为 Canonical,不经过模型。
需要模型时,也不是在 crawler 进程里直接对话。调度器按对象哈希,把已经抽出的文本放入隔离执行环境的 /workspace/inputs/,由一份 不包含校园 CLI 的 预设调用 DeepSeek V4.1 Flash;结束后只收集 /workspace/outputs/,再按同一哈希写回 Canonical。采集进程不持有产品登录态。这些产出进入公开知识库,而不进入某个用户的私人笔记。
例如:
标题全部丢失
表格列错位
OCR 阅读顺序明显错误
如果一份数字 PDF 本来就能稳定抽出文本,就没有任何理由再让模型「润色」一次。
这是整个文档处理流程里我们非常坚持的一条原则:
模型只修复无法确定恢复的结构,不改写已经正确的事实。
因为每增加一次生成式处理,就增加一次文本漂移的机会。
对于知识库来说,「更漂亮」远没有「仍然是原文」重要。
为什么 OCR 不应该运行在爬虫里面
把 OCR 直接写进 crawler 一开始看起来非常方便:
下载 PDF
↓
OCR
↓
存数据库
但这样会把两个性质完全不同的任务绑在一起。
采集器关注的是:
这个资源存在吗?
它变了吗?
原件保存了吗?
而 OCR 关注的是:
这一页是什么版面?
图片中文字在哪里?
表格应该怎样恢复?
前者主要受网络限制。
后者主要受 CPU、GPU 和模型吞吐限制。
把它们放在同一个执行循环里,就会出现非常奇怪的耦合:
因为一份扫描版教材 OCR 需要很久,所以今天的学院新闻也暂时不能更新。
因此归一化最终成为 crawler 仓库里的另一套命令,而不是 crawler 主循环的一部分。
它消费的是对象哈希:
sha256:...而不是 URL。
这个区别很重要。
URL 是外部世界的位置。
SHA-256 是我们已经拥有的事实。
归一任务失败可以反复执行,而不需要再次访问源站。
以后即使 OCR 模型从 PaddleOCR-VL 换成另一套实现,也只需要重新消费已有对象。
需要 Flash 的对象同样按哈希投递。同一份原件可以重放隔离执行,而不必重新爬取,也不必让模型去「自己上传」。
整个采集层不需要改变。
Chunking 不是每 500 字切一刀
当所有文档终于被统一成 Markdown 后,向量化反而变成了一个比较普通的问题。
最简单的切片方法当然是:
每 500 字切一段这种方法的问题是,它完全不知道文档结构。
一条规定可能在第 499 个字开始:
学生申请缓考需要满足以下条件:然后下一块只剩:
1. 二级甲等以上医院证明
2. ...
单独召回第二块时,语义已经残缺。
既然 Markdown 已经保留了标题层级,就没有必要丢掉它。
因此我们优先按照:
# / ## / ###切分。
同时给每个 chunk 注入自己的文档路径。
例如:
> 路径:教务管理办法 > 成绩与绩点评定 > 缓考申请条件

学生因病无法参加期末考试的,须在考试前向开课学院提交二级甲等以上医院证明……
这样即使一个 chunk 被独立召回,它仍然知道自己属于哪里。
在较长段落之间,再保留少量 overlap,避免跨段逻辑被完全切断。
于是到了这一步,Embedding 模型收到的已经不再是:
某个 PDF 第 18342~18842 个字符而是:
来源
章节路径
正文
原文哈希
文档版本
向量模型真正负责的事情只剩下:
把这段已经整理好的知识映射到语义空间。
一个公开知识库,而不是几十个学院知识库
另一个容易产生的设计是:
机械学院 → 一个知识库
计算机学院 → 一个知识库
教务处 → 一个知识库
……
这会很快制造出新的问题。
用户的问题并不会按照组织架构出现。
例如:
转专业以后培养方案里的高数怎么认定?这个问题可能同时涉及学院通知、教务规定和培养方案。
因此公开校园语料进入的是同一个 WeKnora 知识库。
来源差异保存在 metadata 中:
source
item_id
url
published_at
content_hash
asset_sha256
需要时按照 metadata 过滤,而不是提前把知识物理拆散。
用户自己上传的私人知识库则保持另一条完全独立的路径。
两者的边界非常明确:
公开校园知识
        ↓
      WeKnora

用户私人知识
        ↓
   TJUClaw Go API
我们并不希望为了方便检索,把公共数据和用户数据混成一个身份空间。
搜索是一种 Agent 工具,而不是产品终点
最终,这套知识库主要不是为了让人打开一个搜索框。
真正的消费者是 Agent。面向用户的 会话与流水线清洗使用同一套 DeepSeek V4.1 Flash,但提示词不同:用户侧可以调用 tjucli;清洗预设里不出现校园工具。
在沙箱里,面向用户的 可以执行:
tjucli knowledge search "软件工程培养方案"背后的路径是:
用户问题
    ↓
π Agent
    ↓
tjucli
    ↓
TJUClaw API
    ↓
WeKnora Hybrid Retrieval
    ↓
Rerank
    ↓
结构化结果
返回给 Agent 的也不是一段无法解释的文本,而是一个确定性的信封:
{
  "ok": true,
  "data": {
    "hits": [
      {
        "title": "...",
        "text": "...",
        "source": "...",
        "url": "...",
        "content_hash": "...",
        "asset_sha256": "..."
      }
    ]
  },
  "error": null
}
语义搜索解决「意思相近」。
BM25 解决「字符串就是很重要」。
对于:
微积分 A(1)
微积分 B(1)
这样的课程名称,完全依赖 Embedding 并不可靠。
所以召回本身仍然是 Hybrid Search,再经过 reranker 留下少量上下文。
LLM 不负责寻找所有事实。
它负责使用检索系统已经找到、并且带有出处的事实。
引用最终应该指向一个哈希
整条数据链路最后还有一个问题:
如果原网页后来变了怎么办?
假设 Agent 今天引用了一份培养方案。
一个月之后,学校更新了同一个 URL。
如果笔记只保存:
https://example.edu/plan.pdf那么用户以后打开它,看到的可能已经不是 Agent 当时引用的内容。
这也是为什么对象存储最终采用内容寻址。
搜索系统可以始终指向最新版本:
(source, item_id)
        ↓
latest canonical document
但一次已经生成的引用保存的是:
content_hash或者:
asset_sha256于是两个需求可以同时成立:
搜索
→ 应该看到最新内容

引用
→ 应该看到当时内容
旧文件因此不能因为新版出现就立刻从 CAS 中删除。
否则整个可复核链条都会断掉。
对于一段进入知识库的内容,我们最终希望知道的不只是:
它说了什么?还包括:
它来自哪里?
什么时候抓到?
是哪一版?
位于哪一页?
经过 OCR 吗?
经过模型修复吗?
对应的原始文件是什么?
这些字段不会让 Embedding 本身更准确。
但它们决定了一套知识系统是否值得信任。
写在最后
做完这条链路以后,我越来越觉得,RAG 系统里最重要的部分往往不是 RAG。
Embedding、向量数据库、reranker 都已经有非常成熟的实现。
真正需要不断做工程判断的,是它们之前那些不那么显眼的问题:
什么时候相信一次抓取是完整的?
文件名和 Content-Type 冲突时相信谁?
一份公开材料里出现手机号以后,它是否还应该进入自然语言搜索?
OCR 的错误应该由规则修,还是让模型重写?
原网页修改以后,以前的引用应该发生什么?
这些问题都没有一个更大的模型可以自动替我们解决。
TJUClaw 目前选择的是一条相对保守的路线:
原始数据尽可能保存
派生过程尽可能可重放
生成式处理尽可能少
每一次检索尽可能带出处
每一次引用尽可能落到确定版本
于是最终交给 Agent 的,可以只是一条很短的命令:
tjucli knowledge search "软件工程培养方案"复杂性没有消失。
它只是被压到了这行命令下面。
而这大概就是数据基础设施应该做的事情。